THINKINGMODELS.SITE
THINKINGMODELS.SITE
7.5THINKINGMODELS.SITE · LAUNCH
COGNITIVE SCAFFOLD
不是再给你一个答案,而是保存答案背后的思考结构
Thinking Models 是一个从真实问题出发,帮助用户调用可溯源思维模型、比较不同判断框架,并将分析转化为最小行动的 AI 认知工具。
它的基本使用过程很简单:
提出问题 → 推荐模型 → 查看来源与边界 → 交叉推演 → 形成最小行动 → 沉淀认知路径
你不需要先学习一百个思维模型。
只需要带着一个最近真正困扰你的问题进来。
01 · 为什么还需要一个思维模型产品?
今天,我们其实已经不缺答案了。
搜索一个概念、问一次 AI、阅读一篇文章,几秒钟后,我们通常就能获得一个看起来相当完整的回答。
但当我们真正面对复杂问题时,困难往往不在于“没有答案”,而在于:
这个结论基于哪些事实?
中间使用了什么判断框架?
为什么选择这个模型,而不是另一个?
不同模型之间是否存在冲突?
哪些内容是事实,哪些只是推断?
这次思考能否成为下一次思考的起点?
一次对话结束后,答案留下了,产生答案的结构却消失了。
我们保存了大量结论,却很少保存自己是如何得到这些结论的。
这就是我做 Thinking Models 的起点。
02 · Thinking Models 是什么?
Thinking Models 是一个可溯源思维模型知识库,也是一套正在生长的认知脚手架。
它不是把一万个模型按照 A—Z 排列起来,也不希望成为另一个“思维模型大全”。
它真正想解决的问题是:
当一个人面对复杂问题时,怎样找到合适的思维模型,理解它的来源和边界,并把分析推进到下一步行动?
这里所说的“脚手架”,并不是替你做决定。
建筑中的脚手架不会代替建筑本身,但它能让人站到原本够不到的位置。
认知脚手架也是如此:它暂时撑住复杂问题中的一段思考,帮助我们把一个模糊的问题,逐渐转化成可以比较、判断和验证的选项。
03 · 一个问题如何被重新组织?
假设你正在思考:
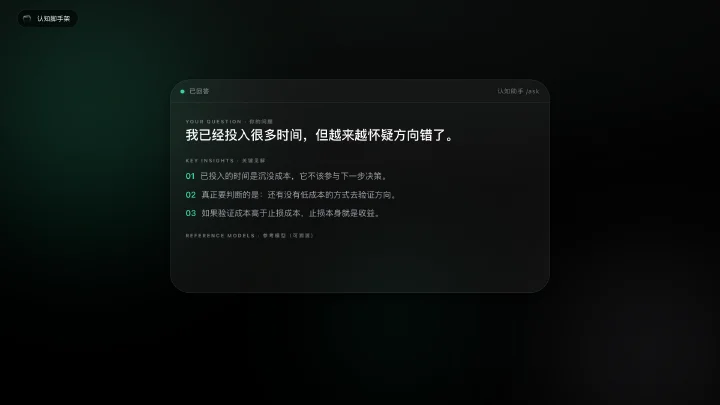
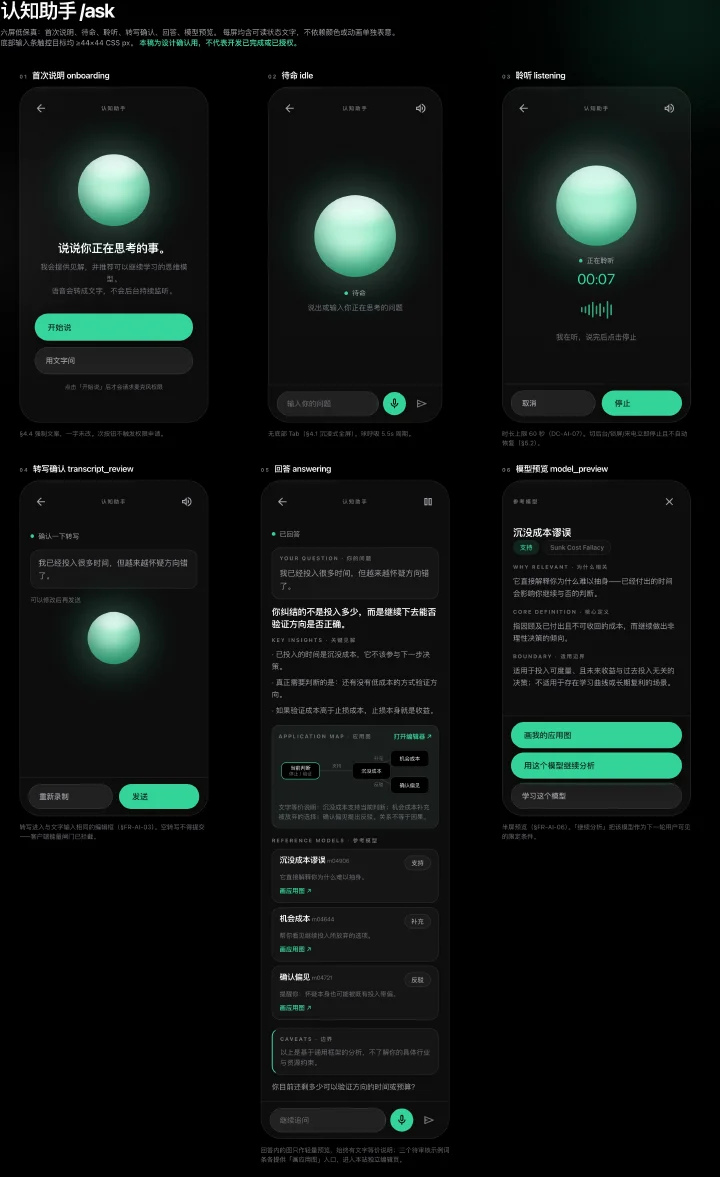
“我已经投入了很多时间,但越来越怀疑这个方向是不是错了。”
我们通常会把问题表达成:
我还要不要坚持?
但这个问题很难直接回答。
Thinking Models 会尝试引入与当前问题相关的模型,例如:
沉没成本谬误
已经投入且无法收回的时间、金钱和精力,不应该直接决定下一步选择。
过去投入了多少,不能证明未来继续投入就是正确的。
机会成本
真正需要比较的,不只是“继续”与“放弃”。
还要考虑:如果继续投入,我会放弃哪些其他机会?同样的资源是否有更值得投入的方向?
把两个模型放在一起后,问题开始发生变化:
我真正需要判断的,也许不是“要不要坚持”,而是还有没有一种成本足够低的方式,可以继续验证这个方向?
接下来,就可以形成一个最小行动:
缩短验证周期;
只测试一个关键假设;
提前设置继续和停止的标准;
用真实反馈代替投入感和不舍感。
模型没有替你决定是否坚持。
但它重新组织了问题,并帮助你找到一个能够带回新信息的动作。
这就是 Thinking Models 想提供的价值。
04 · 产品如何工作?
Thinking Models 目前由五个功能组成:
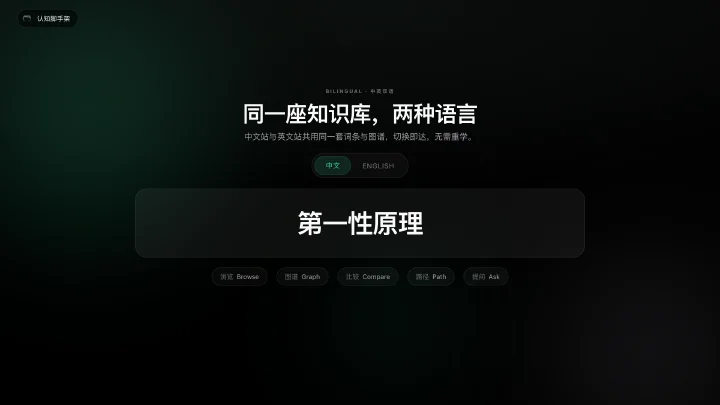
Ask · Browse · Graph · Compare · Path
它们不是五个平行的功能,而是一条逐渐深入的使用路径。
核心入口:Ask,从真实问题开始
在认知助手中,你可以直接写下或说出正在思考的问题。
例如:
两个机会都不错,我应该怎么选择?
为什么这个计划总是在相同的位置卡住?
我是在坚持长期主义,还是只是不愿意止损?
团队意见不一致,真正的分歧在哪里?
认知助手会围绕问题提供关键见解,并推荐可能相关的思维模型。
对于每个推荐模型,你可以继续查看:
为什么它与当前问题相关;
它的核心定义是什么;
它适用于什么情况;
它可能在哪些情况下被误用;
如何使用这个模型继续分析;
下一步可以补充什么信息或采取什么行动。
你也可以设置不同的解释角色与背景偏好,让回答更接近自己的知识水平和思考方式。
Ask 是产品的核心入口:先有问题,再调用模型。
底层支撑:Browse,查找可溯源模型
在思维模型知识库中,可以通过搜索、分类和筛选查找模型。
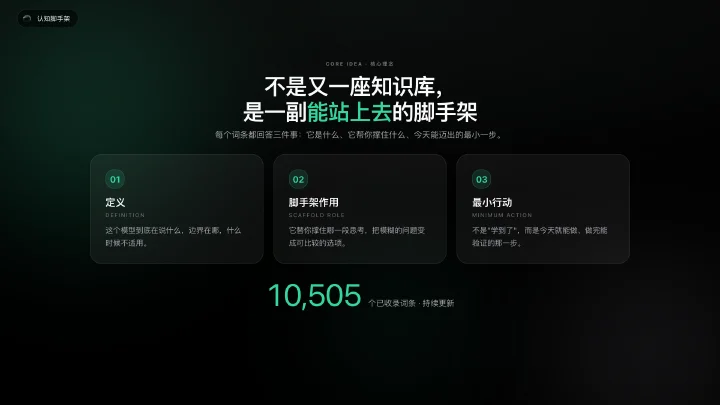
每个模型主要围绕三个问题展开:
1. 定义 Definition
这个模型究竟在说什么?
它的核心概念、成立条件和适用边界是什么?
2. 脚手架作用 Scaffold Role
这个模型能够撑住哪一段思考?
它能否帮助我们发现变量、重新描述问题,或者形成可以比较的选项?
3. 最小行动 Minimum Action
使用模型以后,今天可以多做哪一个动作?
这个动作不追求一次解决所有问题,但应该能够带回来新的事实、反馈或判断依据。
知识库目前建立了包含 10,505 个模型的知识索引,并在持续进行定义校对、来源补充和关系整理。
这个数字代表索引规模,并不意味着所有模型都已经完成同等深度的整理。
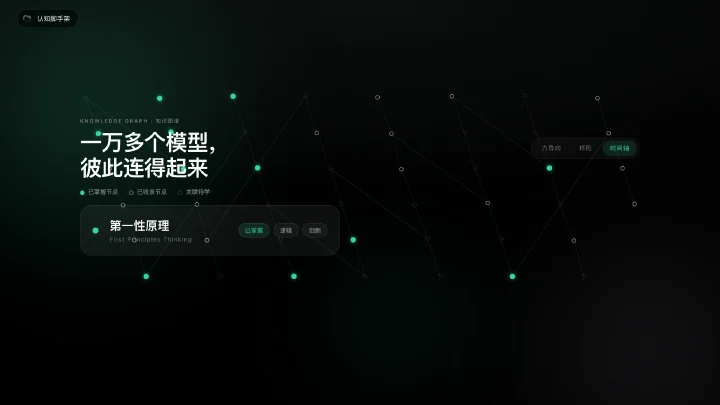
深度工具:Graph,发现模型之间的关系
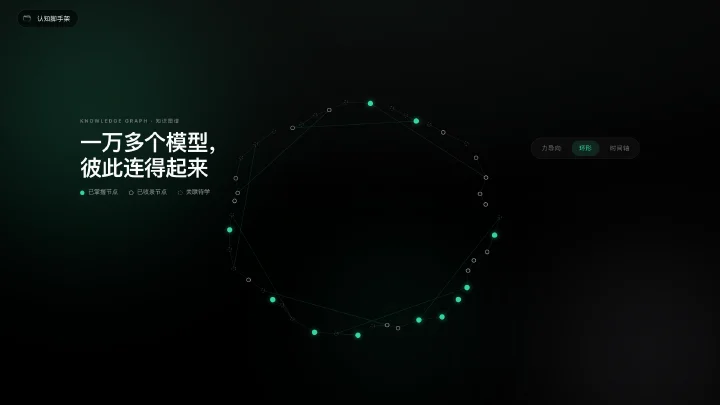
一万个孤立的词条,并不会自动形成知识。
在知识图谱中,可以通过谱系、环形和时间轴等方式,观察模型之间的关系:
哪些模型互相支持?
哪些模型提供相反的解释?
哪些模型存在前置和后续关系?
哪些模型研究的是同一个问题的不同尺度?
一个概念经历过怎样的发展和延伸?
同一个决策问题,可能同时涉及心理学、经济学、系统论和概率。
知识图谱希望回答的不只是“这个模型是什么”,还包括:
这个模型处在怎样的认知结构中?
深度工具:Compare,比较相似与冲突的模型
很多思维模型看起来相似,解决的问题却并不相同。
有些模型甚至会给出方向相反的建议。
通过模型对比,可以把多个模型放在同一个视野中,比较它们的:
核心命题;
观察尺度;
适用场景;
使用边界;
可能盲点;
相互支持或冲突的部分。
例如:
第一性原理和类比思维有什么区别?
沉没成本与长期主义是否冲突?
局部最优与全局最优应该如何配合?
奥卡姆剃刀和汉隆剃刀分别在简化什么?
对比的目的不是选出一个“最正确”的模型。
而是判断:不同模型分别在什么条件下成立。
长期沉淀:Path,形成个人认知路径
知道一个模型,不等于真正能够使用它。
在个人路径中,登录后可以同步学习进度,并逐步查看:
学习和调用过的模型;
认知助手中的模型调用记录;
不同分类的掌握情况;
学习时间线;
下一阶段推荐;
可以继续探索的新模型。
我希望这里最终形成的,不只是一份“读过什么”的记录,而是一份属于个人的认知账本:
我曾经遇到过什么问题?
当时调用了哪些模型?
我的判断发生了怎样的变化?
哪些模型真正改变了我的行动?
05 · 它和通用 AI 有什么不同?
通用 AI 很擅长生成答案。
Thinking Models 更关注的是:答案背后的判断结构能否被看见、检查和继续使用。
通用 AI 通常直接生成结论
Thinking Models 会尽量说明调用了哪些模型,以及这些模型为什么与当前问题相关。
通用 AI 的推理框架容易隐藏在回答中
Thinking Models 会把模型的定义、作用和适用边界单独呈现出来。
通用 AI 可能给出一个听起来合理的统一答案
Thinking Models 鼓励同时调用多个模型,查看它们之间的支持、冲突和不同尺度。
通用 AI 的一次对话通常以“得到回答”结束
Thinking Models 希望把分析推进到一个可以执行的最小行动,并逐步保留模型调用记录。
通用 AI 可以生成观点
Thinking Models 更希望帮助用户检查:
这个观点从哪里来?在什么条件下成立?有没有相反的解释?它是否真的改变了下一步行动?
它不是要替代通用 AI。
而是为复杂问题增加一层可以被检查的认知结构。
06 · 为什么强调“可溯源”?
如果一个系统只是不断生成听起来正确的观点,那么它最终仍然只是另一种形式的答案机器。
所以,Thinking Models 从一开始就把可溯源作为基础方向。
一个模型叫什么,并不是最重要的。
更重要的是:
它最初从哪里来?
原始概念是什么?
有哪些可靠来源?
后来的人进行了哪些扩展?
我们今天使用的是原始理论,还是互联网转述后形成的二手概念?
可溯源不意味着来源一定正确,也不意味着一个模型可以直接套用到任何问题。
它的价值在于:让知识有机会回到出处,被重新理解、质疑和检验。
只有能够回到来源的知识,才有机会被重新检查。
07 · 它适合解决哪些问题?
复杂决策
当两个选项各有利弊,很难仅凭直觉做出判断时,可以从机会成本、可逆性、风险、长期影响等角度重新比较。
例如:
是否应该更换工作?
一个已经投入很久的项目是否应该继续?
应该扩大投入,还是先做一次小规模验证?
项目诊断与复盘
当一个项目持续延期、指标下降,或者团队反复卡在同一个问题上时,可以调用系统思维、约束理论、反馈回路等模型寻找真正的阻塞点。
重点不只是解释“为什么失败”,而是找到:
下一步验证哪个假设,能够最快获得新的信息?
学习研究与检验 AI 答案
进入一个陌生领域时,可以先找到核心模型、前置概念和相互关系,再逐步建立知识结构。
当 AI 给出一个听起来合理的答案时,也可以继续检查:
它使用了什么框架?
前提是什么?
边界在哪里?
有没有相反模型或证据?
从接受答案,转向检查答案是如何产生的。
08 · 已经上线了什么?
Thinking Models 目前仍然处于早期阶段。
已上线的基础能力
思维模型搜索、分类与快速阅读;
文字和语音问题输入;
相关模型推荐与继续分析;
模型定义、作用和适用边界展示;
知识图谱与模型关系浏览;
多模型对比;
登录后的学习进度与个人路径。
正在持续完善
模型原始来源与参考资料;
模型定义和中文表述校对;
模型之间的支持、冲突与演化关系;
认知助手的模型匹配质量;
认知账本与长期思考记录;
从分析到最小行动的衔接方式。
它还不是一座已经完工的知识大楼。
它更像它自己的名字:
一副仍在生长的脚手架。
09 · 怎样开始使用?
不需要先阅读完整个知识库。
只需要三个步骤。
第一步:带来一个真实问题
与其输入“决策”,不如输入:
我同时拿到两个工作机会,一个更加稳定,但成长有限;另一个风险更高,却更接近我的长期方向。我应该如何判断?
问题越具体,模型越容易真正参与判断。
第二步:检查推荐模型
不要只看模型名称。
重点查看:
为什么相关;
核心定义是什么;
适用边界在哪里;
是否存在相反模型;
它有没有帮助你重新描述问题。
第三步:完成一个最小行动
从分析中选择一个今天能够完成的动作。
它可以是:
补充一项关键数据;
询问一个相关的人;
设计一次小规模实验;
明确一个停止条件;
验证一个最关键的假设。
完成以后,再带着新的信息回来继续推演。
10 · 常见问题 FAQ
使用之前需要了解思维模型吗?
不需要。
Thinking Models 的核心使用方式是从问题出发,再寻找相关模型。你也可以通过知识库、图谱和模型对比主动探索。
它会直接告诉我应该怎么做吗?
它会提供判断框架、模型解释和可能的最小行动,但不会替你承担最终决策。
同一个模型放在不同目标、资源和约束中,可能产生完全不同的判断。
AI 给出的分析一定可靠吗?
不一定。
AI 仍然可能出现遗漏、误读和不恰当的模型匹配。
Thinking Models 强调来源、边界和模型对比,正是为了让回答可以被进一步检查,而不是因为使用了某个模型,就默认结论一定正确。
10,505 个模型是否都已整理完成?
没有。
目前建立的是包含 10,505 个模型的知识索引。不同模型的定义、来源和关系完善程度并不完全一致,仍在持续整理和校对。
是否需要登录?
部分浏览和体验功能可以直接使用。
学习进度同步、个人路径和认知记录等个性化功能,需要登录后使用。具体以网站当前页面为准。
输入个人背景时需要注意什么?
只填写分析问题所必需的信息,尽量不要输入姓名、证件号码等个人敏感信息。
使用语音功能时,只有主动点击后才会请求麦克风权限,不会在后台持续监听。
11 · AI 时代,我们需要保存什么?
我越来越觉得,未来真正稀缺的,可能不是“知道更多”。
甚至也不只是拥有一个更聪明的 AI。
真正稀缺的可能是:
我们有没有能力保存自己的思考结构。
知道一个模型,和在现实问题中真正调用它,中间还有很长一段距离。
得到一个答案,和形成一套可以不断检验、修订和继续生长的认知结构,也完全不是一回事。
Thinking Models 想做的,不是替人思考。
而是帮助一个问题获得更多可以站立的支点,让每一次思考不必从头开始。
搭起你的第一副认知脚手架
不用先学习一百个思维模型。
带着一个最近真正困扰你的问题进来,就可以开始。
进入认知助手:
thinkingmodels.site/ask
浏览思维模型知识库:
thinkingmodels.site
如果你也在思考:
AI 时代,我们应该怎样保存、组织并继续自己的思考?
欢迎来试一试。
也欢迎挑错。
THINKINGMODELS.SITE
COGNITIVE SCAFFOLD · A SOURCED MENTAL MODELS LIBRARY