ModelBench
ModelBench
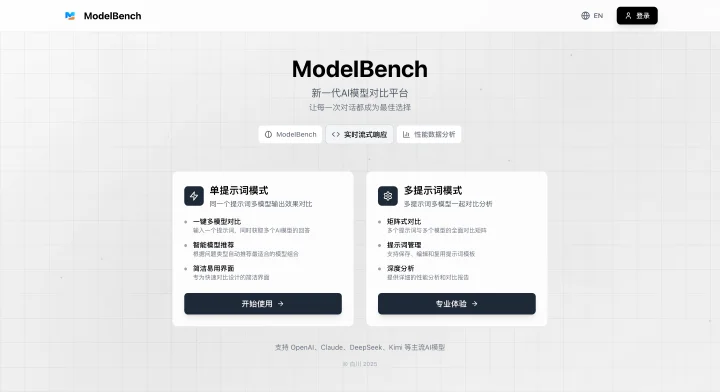
待猹分ModelBench 是一款 AI 模型横向对比与提示词测试平台。
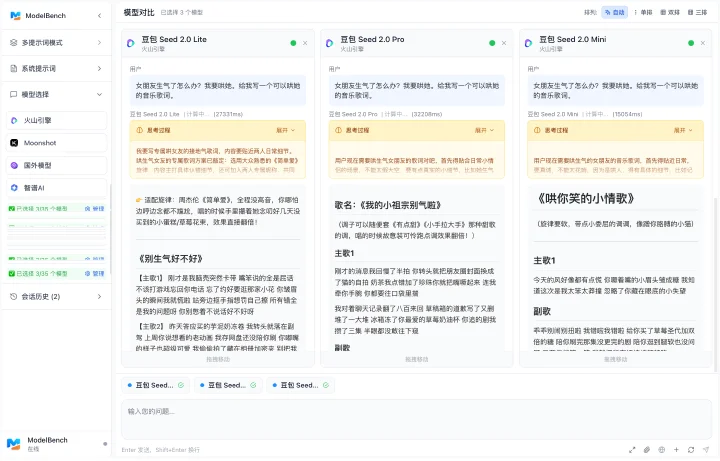
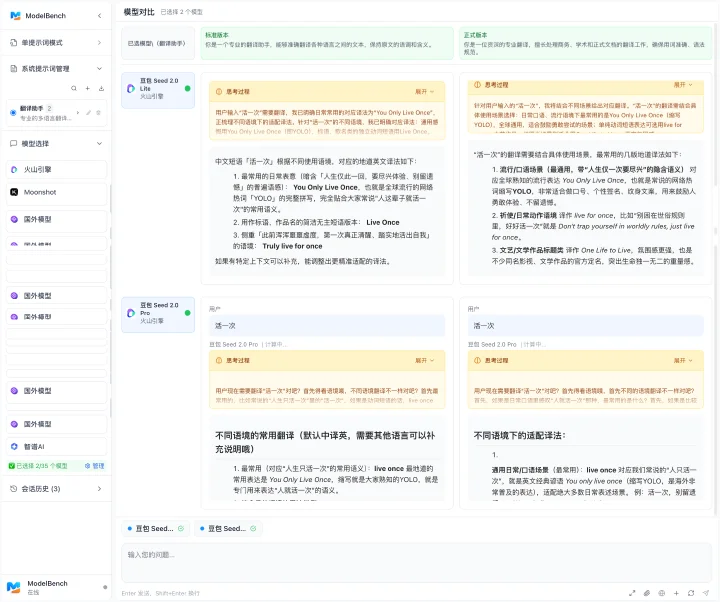
面对越来越多的大模型,用户常常需要在不同平台之间反复复制问题、切换窗口,再凭感觉判断哪个模型更好。ModelBench 将这一过程集中到一个界面中:只需输入一次问题,即可同时调用多个模型,并排查看它们的回答效果、响应速度、Token 消耗与费用估算,更快找到适合自己的模型和提示词。
核心亮点
多模型并行对比
同一个问题同时发送给多个 AI 模型,回答并排呈现,差异一目了然。实时流式响应
逐字展示模型输出,直观比较首字响应速度、生成过程和整体耗时。提示词矩阵测试
支持“多条提示词 × 多个模型”组合测试,批量验证不同写法和模型搭配,快速找到更优方案。多维性能指标
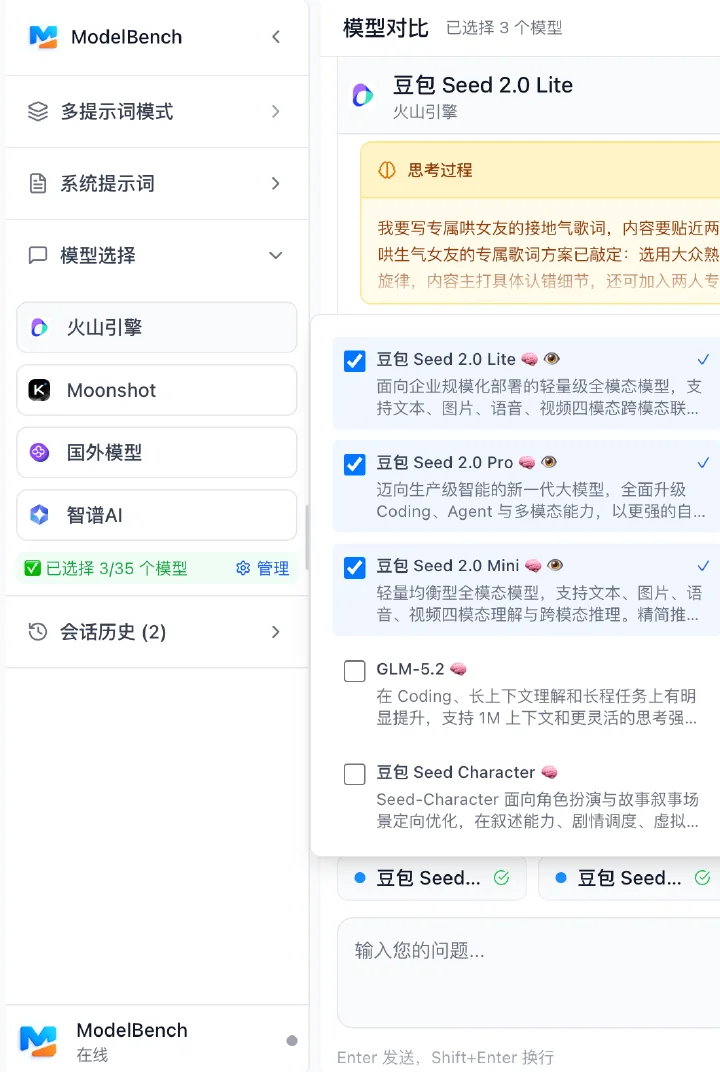
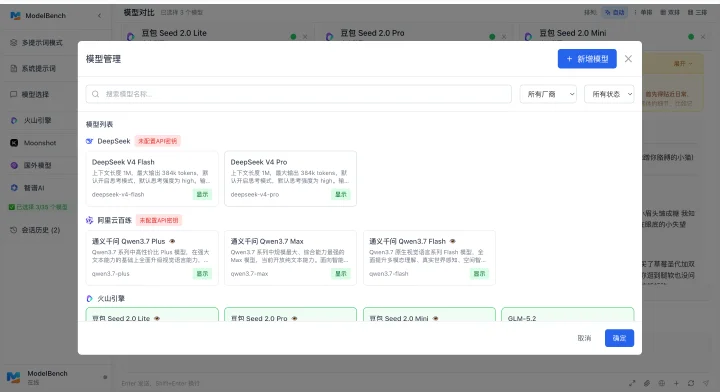
同时查看回答内容、响应时间、Token 消耗和费用估算,不只比较“答得好不好”,还可以衡量速度与成本。灵活的模型管理
覆盖 DeepSeek、通义千问、豆包、Kimi、Claude、GLM 等多种模型,并支持添加自定义模型。便捷的结果管理
支持历史会话保存、模型排序和结果切换,方便复盘、演示与持续测试。适配多种设备
提供深色与浅色主题,并适配桌面、平板和手机。
适用场景
模型选型
在真实业务问题下比较不同模型,找到效果、速度与成本更加均衡的方案。
提示词优化
批量测试不同提示词写法,观察各模型表现,减少反复手动试错。
AI 产品开发
帮助开发者验证模型能力、响应稳定性和调用成本,为产品接入提供参考。
内容与办公任务
对比不同模型在写作、总结、翻译、分析和代码生成等任务中的表现。
产品演示与团队评审
通过统一界面展示多个模型的实时回答,让模型能力差异更直观、更容易讨论。
为什么选择 ModelBench?
选择 AI 模型,不应该只看排行榜或宣传参数。模型在具体任务中的回答质量、响应速度和使用成本,才是真正影响使用体验的因素。
ModelBench 把分散、重复的模型测试过程变成一次直观的横向实验,让每一次模型选择都有真实结果作为依据。
FAQ
Q:ModelBench 是一个新的 AI 模型吗?
A:不是。ModelBench 是模型对比与测试平台,帮助你在同一界面调用并比较多个 AI 模型。
Q:使用前需要准备什么?
A:根据需要配置相应模型服务商的 API Key,即可选择模型开始对比。
Q:可以一次测试多个问题吗?
A:可以。矩阵测试支持将多条提示词与多个模型组合运行,适合进行批量评测。
Q:适合哪些用户?
A:适合 AI 产品经理、开发者、内容创作者、研究人员,以及正在进行大模型选型和提示词优化的团队。