今天正好有时间,想着深入去分析一下 Perplexity 这个「矛盾」的产品,让我们开始~
产品定位,一句话:一个服务于研究人士的 AI 垂类搜索工具,但产品定位太垂了
一、Perplexity 200 美金一个月,真的值得吗?
作为一个 1 年以来一直付着钱买 Max 的用户,我的答案是一句拧巴的话:它是我用过可信度最高的研究工具,同时也是我见过定价结构最拧巴的 AI 产品。我一直想着把它对标 ChatGPT 和 Claude,也在拼命找着它能够替代 Claude 和 ChatGPT 的地方,但实在是找不到:难,太难了!
一个 Perplexity Max 用户的真实账单:
我实际体验 + 调研下来发现它真是一个集矛盾于一身的 AI 产品。说它对标 Chrome 吧,它确实又很 Agentic,Comet 支持斜杠快捷指令、后台助理(background assistant,可以同时跑多个浏览器任务)、工作流模板,还兼容全部 Chrome 扩展,一套下来和 Claude 的 Skill 生态神似。说它是纯正的 Agent 产品吧,又觉得它着实不配。
不配在哪?在 Computer 的计费机制上。我这个 $200 / 月的 Max 会员,每月可以领 10,000 个 credits,而按我自己的实际使用,一个基础的小型任务平均要烧掉 50-100 个 credits。更离谱的是官方规则:任务中途失败,已消耗的 credits 照扣,不自动退还。也就是说,我在为它的失败率付费。每个月下旬看着余额等刷新的那种感觉,用「苟活」形容不算夸张。
但作为一个理想主义的 AI PM,我还是得回答三个问题:它为什么这么设计、代价是什么、换我我怎么改。
它为什么用 credits 配额制,而不是 Claude 和 ChatGPT 那种时间窗口配额?
倍率制成立的前提,是单次调用的成本方差小、可预测。而 Perplexity Computer 是编排 19 个模型跑端到端任务的系统,一个任务可能串起几十次模型调用和网页操作,单任务成本方差极大。如果按次或按时间窗限流,会被重任务用户直接击穿毛利。所以 credits 的实质,是把任务成本的不确定性从平台转嫁给了用户。自然,任务失败后也不可能退还就是了,就是 toks 烧掉了。
代价是什么?财务上自保了,体验上灾难了。用户在任务开始前不知道要花多少,任务失败了还要买单,这等于同时承担了成本的不透明和结果的不确定。对一个刚起步、最需要用户高频跑任务来打磨 Agent 能力的产品来说,这个机制在惩罚它最想要的行为。
换我怎么改? 三步:任务启动前给 credits 明确消耗的预估区间;失败任务自动返还(至少部分返还);超出预估需二次确认。核心思路是把「成本转嫁」改成「成本透明」,让用户敢跑任务。
二、产品硬刚 Google 失败,转战 Agent 后再战
从演进形态和官方 blog 来看,Perplexity 的初衷是专注研究场景,做一款高可信、高实时、来源可追溯的垂类搜索工具。2025 年 Comet 横空出世后,它进入了 Agent 时代。这中间可以合理推断,它经历了一次承认失败后的成功转身:它承认在信息型搜索的消费端主战场,无法同时打赢 Google 在分发环节的绝对霸权和 ChatGPT 在大众心智上的霸权,于是把核心资产(检索的可信)迁移到 AI-native 浏览器 + 执行型 Agent 上,用先发速度换时间窗口。
这个判断在 2026 年拿到了硬证据。第一,2026 年 2 月它彻底放弃广告业务,转向订阅 + 按量计费,次月收入跳涨约 50%,ARR 从 2025 年 9 月的 2 亿美元冲到 2026 年 3 月的 4.5 亿。第二,它开始疯狂补分发课:拿下三星 Galaxy S26 的 OS 级接入(第一家获得三星设备系统级权限的非 Google 公司)、Computer 集成进 Microsoft 365。第三,Comet 完成全平台落地(桌面 2025-07、Android 2025-11、iOS 2026-03),企业版支持 MDM 静默部署。
三、用户数据:73.6% 的直接访问 & 流量下滑与收入暴涨的同框
第一是用户访问量:根据thestacc.com整理的《Perplexity AI Statistics 2026》, Perplexity.ai 的直接用户访问量约为71.6% 到 73.6%.
这个数字是双面的。正面读,用户是自己记住网址、主动敲进地址栏来的,「研究就上 Perplexity」的心智强度极高,这是它最真实的品牌资产。反面读,这说明它几乎没有外部分发管道,增长全靠自然口碑,没有任何入口给它导流。同一个数字,同时证明了它的品牌护城河和它的分发短板。三星和微软的合作,就是在给这条腿装假肢。
第二个是流量下滑与收入暴涨的同框。消费端访问量环比在跌、全球网页流量份额从 2026 年 3 月的 2.0% 缩到 5 月的 1.3%,但同期 ARR 翻着倍涨。这两条曲线的背离,恰恰是它在主动放弃消费端流量战场的证据:,把资源开始不断押到企业席位和按量计费的 Agent 收入上。Comet 2026Q1 约 300 万 MAU,对一个浏览器来说还是零头,但它承载的是下一个故事:不跟 Google 正面刚流量入口,但争夺 Agent 的被委托任务权。
所以用户行为的分层可以说得更狠一点:
需要快速研究、追踪新闻、查证资料时,用户想到 Perplexity;
写作、编程、长期协作时,转向 Claude 和 ChatGPT;
导航、本地服务、购物,还是 Google。
它拿到了一个高价值场景,但没拿到默认入口权,而且从数据看,它自己已经不打算在消费端抢这个入口权了。
四、算账:$200 的 Max 我到底买到了什么
先说结论:Perplexity 的服务撑不起它 200 美金的价格。。。
算一笔账:同样是每月 $200,三家给的东西完全不同:Claude Max 20x 给你 20 倍于 Pro 的用量额度加 Claude Code,跑的是当前最强的编码模型;ChatGPT Pro 给你 GPT-5 Pro 级模型、图像视频语音的全家桶和用量阶梯;Perplexity Max 给你的是无限 Labs 加 10,000 个 Computer credits。
把 credits 换算一下:10,000 credits ÷ 每任务 50-100 credits(有浮动) ≈ 每月 100-200 个任务,折合每个任务 1-2 美元,还要自担失败损耗。也就是说,同样的钱,在别家买到的是「顶级模型 + 高配额」,在 Perplexity 买到的是一个按任务计价、单价 1-2 美元、不知道一个任务究竟要花多少钱、失败不退款的 Agent 计件服务。这笔账算完,「值不值」就不再是感受问题,而是一个可以摆在桌面上的纯算数问题。
五、回答我自己的问题:为什么我不能在别家复刻它
现在我来正面回答。能复刻的是工作流层:快捷指令、任务模板、多步编排,这些 Claude 的 Skill、ChatGPT 的 GPTs 都能搭出来,Perplexity 在这一层没有壁垒。复刻不了的是检索层:自建实时索引(PerplexityBot 自有爬虫,与 Google 索引域名重合度只有 49.6%)、比 Google 新鲜 3.3 倍的内容时效、每次查询检索 5-15 个来源甚至更多且引用与检索管线紧耦合的架构,以及第三方评测里全品类最低的 37% 错误率,接入专业级知识库检索。这一层是它真正的护城河。
Perplexity 的可防御资产在检索层,但它的 $200 定价却挂在了最可复制的 Agent 工作流层上。定价结构和护城河结构,是错位的。
这也解释了我作为用户的全部拧巴:我愿意为它的检索付钱(那是别家给不了的),但它偏要我为它的 Agent 计件付钱。
六、结论
回到标题的问题,$200 值不值。我的答案是分层的:Perplexity 的检索值钱,Max 的定价方式不值。它是一款在产品质量上赢了比赛、在生意结构上还没找到正确收费姿势的公司。
如果让我给它提三条建议:第一,Computer 计费改「成本透明」三件套(预估区间、失败返还、超额确认),先让用户敢跑任务;第二,把定价锚点从 Agent 计件迁回检索资产,比如把实时索引和高可信检索做成独立的高价 API 订阅层,向愿意为「可信」付钱的专业用户和企业(例如咨询公司)收钱;第三,珍惜那 73.6% 的直接访问。
我依然每天用它查资料,依然会在下个月纠结要不要续费 Max。一个让付费用户这么拧巴的产品,要么在犯错,要么在转型的半路上。我倾向于是后者,但转型的路上,请先把 credits 这个机制改了。
最后夸一下:
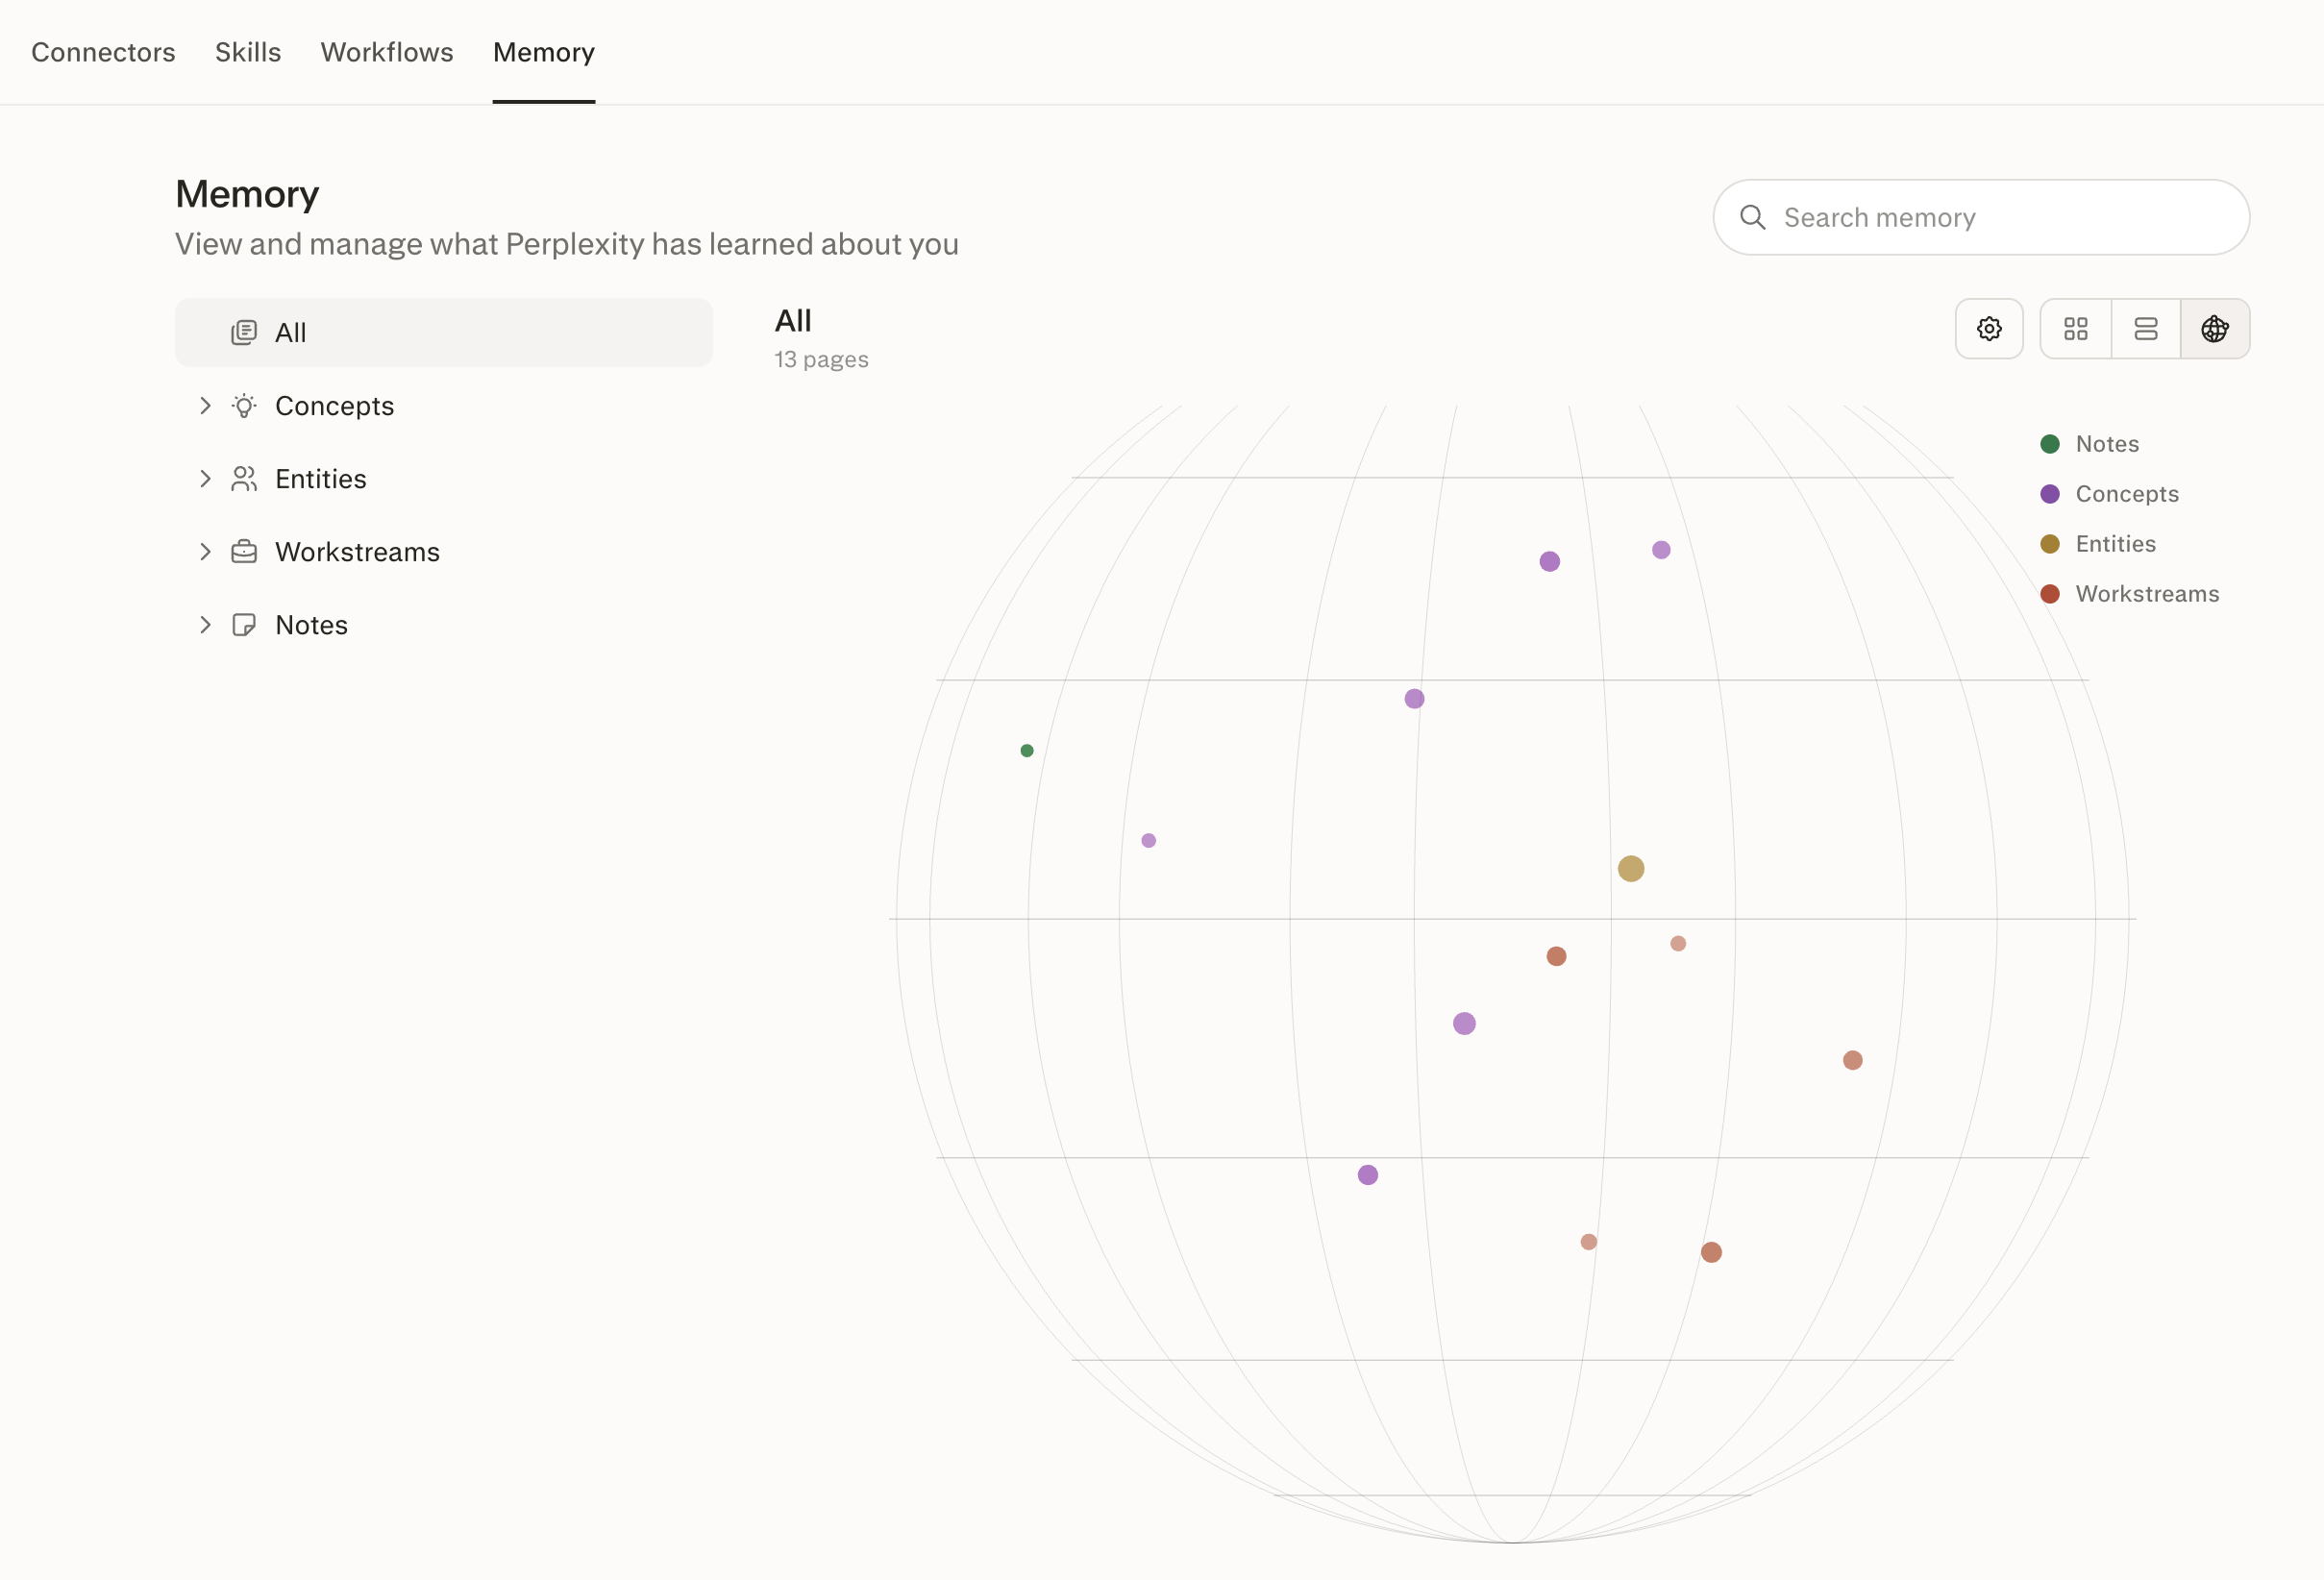
最后想夸下 Perplexity 的 Memory 功能,知识能关联出 node 来了,开始像 Obsidian 了,我因为太喜欢删聊天记录所以整个记忆库没成体系,以后会慢慢沉淀,希望 Memory 可以让用户手动导入 Memory 或者直接 sync 其他 Agent 的 Memory。
备注:ARR ≈ 预测某 SaaS 产品在未来一年内的可预测性订阅收入(当前订阅用户数 * 每月订阅费 * 12 个月)
如数据论据有误,希望大家积极反馈,我会积极改正,致力于给出客观理性的分析,为观猹提供更多高质量 AI 分析。
写稿人:碳基 Tom 手写撰稿 + 校准
调研数据:Perplexity + 硅基 Tommy + 人工检索与核查